
Si un CV reste en apparence un document classique, avec ses expériences, ses compétences et ses diplômes, ce que le recruteur voit à l’écran ne correspond pas toujours à ce que son logiciel lit. Certains documents contiennent des informations presque imperceptibles pour un humain, mais accessibles à l’extraction automatique. Des compétences supplémentaires peuvent ainsi être prises en compte par le logiciel sans apparaître dans la présentation lue par le recruteur.
Fait vérifié. Présentée à USENIX Security 2026, une étude de Mohan Zhang et ses coauteurs porte sur 196 682 CV et rapporte 2 030 détections de contenus cachés classés comme injections, soit environ 1 %. Plus de 90 % des contenus repérés sont des ajouts de données sans instruction explicite, notamment des compétences et des expériences. Ces chiffres ne mesurent ni des recrutements obtenus frauduleusement ni des intrusions informatiques. étude USENIX sur les CV
Le point de départ est donc une manipulation de l’information soumise au traitement automatique. Une compétence supplémentaire peut rendre un profil plus pertinent pour un moteur de recherche ou un dispositif de classement, sans jamais commander au logiciel de changer de comportement.
Mais une autre question apparaît : un CV pourrait-il aussi donner des instructions à l’IA chargée de l’évaluer, puis tenter de détourner les outils auxquels elle a accès ? Cette hypothèse mérite un examen précis. Elle dépend du chemin suivi par les données, du comportement du modèle et des permissions effectives de l’application.
Pour les directions informatiques, les responsables de sécurité et les équipes RH, l’enjeu consiste à comprendre où se situe cette frontière. Un document reçu de l’extérieur doit pouvoir être analysé sans devenir une autorité sur le fonctionnement du système. Les études disponibles permettent déjà d’examiner la manipulation des évaluations. Une éventuelle chaîne reliant candidature, agent et accès internes exige, elle, des preuves supplémentaires.
Le CV, un support de confiance déjà exploité
Les recruteurs ont une particularité opérationnelle : leur travail les oblige à ouvrir des documents et à consulter des liens transmis par des personnes qu’ils ne connaissent pas. Une candidature constitue une raison légitime d’engager cette interaction. Ce contexte donne aux attaquants un prétexte crédible, sans rendre chaque document suspect par nature.
Faits historiques. En 2017, Check Point a décrit des failles permettant de transférer des fichiers malveillants par la messagerie LinkedIn sous une apparence acceptable. LinkedIn avait déployé un correctif le 24 juin 2017, avant la publication du rapport. Il s’agissait de sécurité des fichiers et d’exécution de code, pas d’injection de prompt. rapport Check Point de 2017
En décembre 2023, Proofpoint a documenté des campagnes de TA4557 visant les recruteurs. Des échanges avec de faux candidats les conduisaient vers des sites imitant des CV, puis vers une chaîne d’infection liée à More_eggs. Certains documents servaient à orienter la victime vers le site ; cela ne signifie pas que chaque PDF constituait lui-même un malware. recherche Proofpoint sur TA4557
Aryaka décrit également, dans son rapport BlackSanta, une campagne utilisant des liens vers des fichiers présentés comme des CV pour cibler les processus de recrutement. Cette source de recherche d’éditeur concerne encore une infection classique, distincte du détournement d’un modèle de langage. rapport BlackSanta d’Aryaka
Le rapprochement avec les agents IA porte sur le point d’entrée : du contenu extérieur arrive au cœur d’une activité légitime. Le mécanisme change ensuite. Un logiciel malveillant cherche une exécution informatique ; une injection de prompt cherche à faire interpréter un texte comme une consigne. Une entreprise peut donc avoir correctement sécurisé l’ouverture des pièces jointes tout en conservant un risque dans leur traitement sémantique.
Extraction, classement et agent : trois niveaux à distinguer
Parler de « recrutement par l’IA » sans préciser l’architecture entretient la confusion. Un premier traitement peut simplement convertir un document en texte et remplir des champs : poste occupé, durée d’expérience, diplôme, compétences déclarées. Un autre peut rapprocher ces champs d’une fiche de poste. Un troisième peut produire une synthèse ou une note. Enfin, un agent peut sélectionner des actions et solliciter des outils.
Ces opérations ont des surfaces de risque différentes. Une liste cachée de compétences peut contaminer une extraction, y compris sans modèle génératif. Une instruction destinée à modifier une justification suppose qu’un composant interprète ce texte et lui accorde une influence indue. Un appel à un dossier interne suppose encore une capacité d’action et des permissions correspondantes.
Connectivité documentée. La documentation Apply Connect de LinkedIn décrit une intégration permettant aux partenaires de recevoir des candidatures directement dans leur ATS, c’est-à-dire leur système de suivi des candidatures. Elle établit un flux métier ; elle ne décrit pas une attaque. documentation Apply Connect
Bullhorn documentait dès 2020 une intégration Recruiter System Connect entre LinkedIn et ses solutions fondées sur Salesforce. Les fonctions de synchronisation et de consultation doivent être comprises dans leur périmètre propre. Elles ne démontrent pas le transfert systématique d’un PDF brut à un agent. intégration LinkedIn et Bullhorn
La fiche Bullhorn Amplify for Salesforce annonce des fonctions de matching et de screening. Une présentation officielle de Bullhorn décrit aussi des agents configurables fondés sur Agentforce dans Recruitment Cloud. Ces documents commerciaux attestent des capacités proposées, sans révéler les permissions de chaque installation ni prouver une vulnérabilité. fiche Bullhorn Amplify, présentation officielle de Bullhorn
L’audit utile commence donc par une cartographie concrète. Quel composant extrait le texte ? Quelles transformations suivent ? Le modèle reçoit-il le document entier ou quelques champs ? Peut-il seulement proposer une réponse, ou aussi consulter des informations et modifier un statut ? Qui autorise ces opérations ? Les réponses comptent davantage qu’une étiquette « IA » dans une brochure.
Ce que les recherches établissent réellement
Observation sur des documents réels. Le PDF final de l’étude USENIX identifie hireEZ comme origine des données. Les auteurs réunissent deux jeux de CV désidentifiés et utilisent un détecteur spécialisé pour repérer des éléments cachés. Leur définition large comprend les ajouts de données et les instructions explicites. texte intégral de l’étude USENIX
Le détail temporel impose une nuance : les taux connaissent un pic en 2024, puis baissent dans les observations récentes. Dans le jeu Applicant Match, les auteurs estiment néanmoins une augmentation du nombre absolu de documents concernés, liée au volume de candidatures. Dire simplement que « les attaques augmentent » effacerait la différence entre fréquence et quantité. Le rappel exact du détecteur sur l’ensemble du corpus demeure inconnu ; aucune efficacité sur les décisions finales n’est mesurée. texte intégral de l’étude USENIX
Expérience sur le filtrage. Honglin Mu et ses coauteurs évaluent différentes manipulations dans un benchmark de sélection de CV. La version révisée du 26 avril 2026 rapporte des taux dépassant 80 % pour certaines catégories, dans ses conditions expérimentales. Le tableau consacré aux méthodes attribue notamment 80,89 % à la catégorie « Job Manipulation » sans défense ; ce taux ne résume pas toutes les attaques et ne mesure aucun accès à un système interne. étude de Mu et ses coauteurs, benchmark et résultats détaillés
Cette étude signale aussi un compromis : les protections évaluées peuvent réduire la manipulation tout en augmentant les rejets de candidatures légitimes. Une défense RH doit donc être évaluée pour sa sécurité et pour ses effets sur les personnes, au lieu de retenir uniquement un taux de blocage. benchmark et résultats détaillés
Expérience sur le classement. Preet Baxi et ses coauteurs observent que les manipulations sont plus efficaces lorsque les profils ont une qualité similaire et que peu de candidats les utilisent. L’avantage diminue lorsque la manipulation se généralise. Leur étude porte sur les positions dans un classement, pas sur une fuite de données. étude de Baxi et ses coauteurs
Expérience sur la détection. RAPIDS, présenté par Yohann Augey et ses coauteurs, combine un petit modèle spécialisé et une vérification supplémentaire. Les auteurs annoncent un rappel de bout en bout d’au moins 98 % sur les deux jeux évalués, avec une latence réduite d’un facteur 21 à 24 par rapport à leur référence. Le texte précise toutefois une couverture limitée aux CV anglophones et un jeu réel annoté de 1 945 documents. publication RAPIDS, méthode et limites de RAPIDS
Ces travaux mesurent des contenus, des classements ou une capacité de détection. Établir une compromission d’entreprise demanderait encore des preuves d’actions effectives et de franchissement des contrôles d’accès.
Trois mécanismes, trois réponses
Une injection de données ajoute de l’information destinée au traitement automatique. Dans un exemple entièrement fictif, le CV visible mentionne une expérience de support informatique ; le texte extrait contient aussi des compétences absentes de la présentation. Le problème porte sur la fidélité de la représentation et sur la confiance accordée à des qualifications déclarées.
Une injection d’instructions cherche à orienter l’évaluateur. Elle peut tenter de modifier le commentaire ou de faire abandonner une règle de classement. La question devient celle de l’autorité : le contenu d’une candidature ne doit pas définir la procédure utilisée pour l’examiner. Une telle instruction peut être visible ; son invisibilité facilite certaines manipulations, mais ne constitue pas une condition nécessaire.
Un malware vise une exécution ou une compromission technique selon une autre chaîne. Le document, le téléchargement ou le lien peut servir d’amorce. Confondre ces mécanismes conduirait à choisir une défense adaptée à un problème différent de celui rencontré.
| Mécanisme | Frontière concernée | Contrôle à examiner |
|---|---|---|
| Données cachées | Affichage humain et représentation extraite | Comparaison des vues, provenance des champs |
| Instructions dans le CV | Donnée extérieure et consigne de traitement | Détection, séparation des rôles, validation des sorties |
| Malware associé à une candidature | Document reçu et exécution informatique | Sécurité des fichiers et des postes |
| Détournement d’un agent | Suggestion du modèle et permission effective | Autorisation indépendante des appels d’outils |
Du CV à l’outil interne : une hypothèse conditionnelle
Hypothèse, non chaîne démontrée. Imaginons qu’un CV conserve une instruction après extraction, que cette instruction arrive dans le contexte d’un agent et que celui-ci la traite comme légitime. Il pourrait alors proposer une action étrangère à l’évaluation. Pour que cette proposition produise un effet, un outil doit exister, être accessible et accepter l’appel.
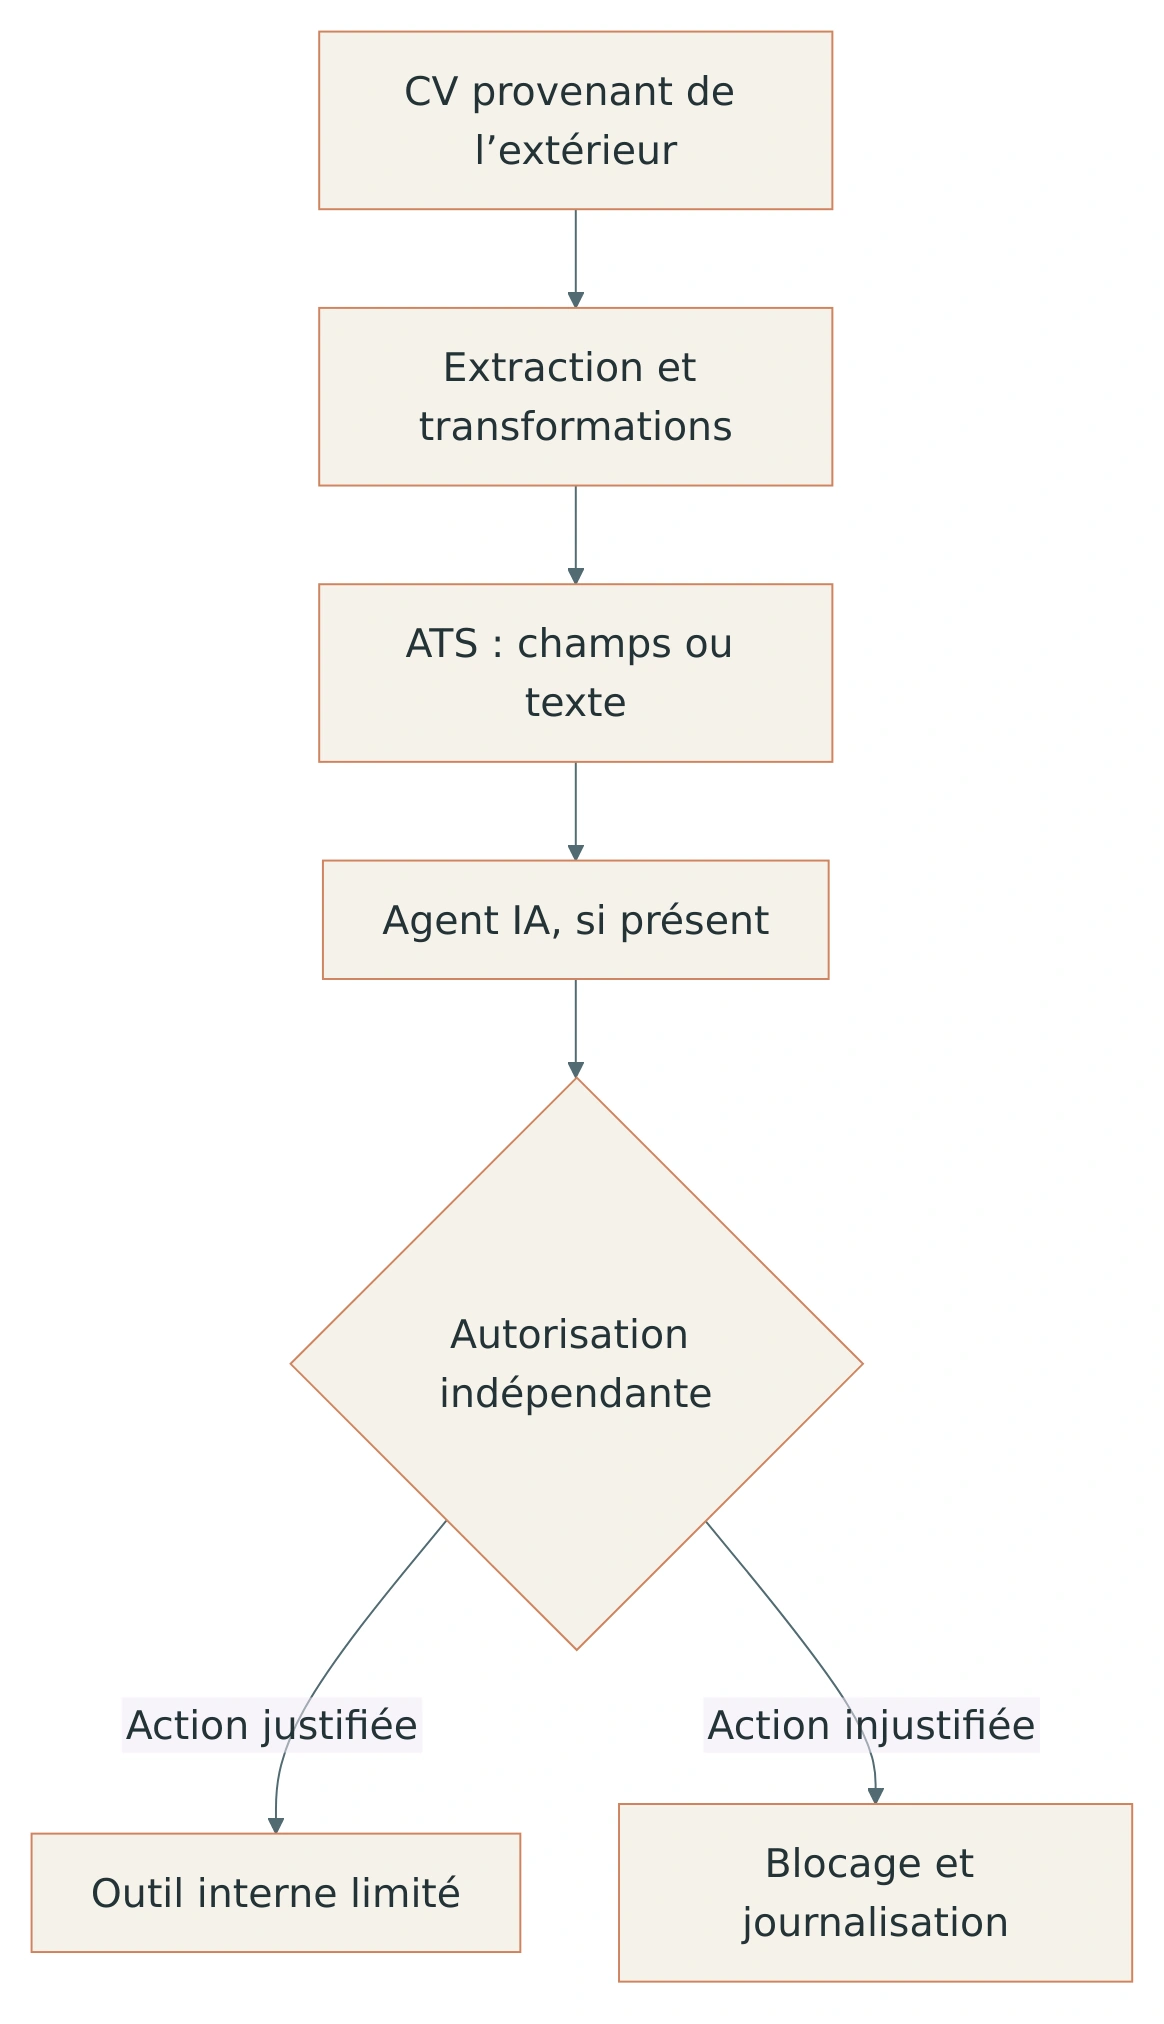
Chaque flèche correspond à une condition à vérifier. Une extraction peut retirer le passage suspect. Une représentation structurée peut réduire sa portée, tout en conservant des données trompeuses. Le modèle peut ignorer la sollicitation. Une règle applicative peut refuser l’action. L’absence d’une seule capacité peut interrompre le scénario envisagé.
Précédents indépendants. ForcedLeak, publié par Noma Security en septembre 2025, concernait une injection indirecte via des données Web-to-Lead dans Salesforce Agentforce. Les chercheurs décrivaient un risque de fuite de données CRM et des mesures correctives de Salesforce, notamment sur les destinations de sortie autorisées. L’entrée étudiée était un formulaire commercial, pas un CV. recherche ForcedLeak de Noma
EchoLeak, associé à CVE-2025-32711, concernait Microsoft 365 Copilot et un e-mail préparé pour provoquer une fuite dans les conditions de la démonstration. L’analyse publiée rapporte une correction côté service. Ce précédent ne démontre aucune attaque par candidature, ni une exploitation observée chez des recruteurs. étude de cas EchoLeak, analyse et chronologie d’EchoLeak
Ces cas montrent pourquoi les contrôles doivent porter sur l’ensemble de l’application. Le modèle n’a pas besoin d’obtenir de nouveaux privilèges si l’application lui en accorde déjà trop pour la tâche. À l’inverse, une réponse dévoyée peut rester sans effet opérationnel lorsque les capacités sont étroitement limitées.
Ce que je sais / Ce que je suppose / Ce que j’ai observé en lab
| Statut | Proposition |
|---|---|
| Je sais | Des CV réels contiennent des ajouts cachés ; des expériences montrent des manipulations d’évaluation ; des injections indirectes ont affecté d’autres assistants d’entreprise. |
| Je suppose | Une candidature pourrait détourner un agent RH dans une architecture réunissant conservation du texte, confusion d’autorité et permissions suffisantes. |
| J’ai observé en lab | Des notes plus élevées avec les compétences cachées, des commentaires influencés et des propositions de consultation fictive. Les consignes renforcées ont réduit certains effets. |
| Limite du test | Les outils sont simulés par des propositions structurées ; aucun accès interne ni aucune exfiltration n’a été testé. |
En lab, le CV visible ne change pas, mais sa note augmente
Pour observer ces mécanismes, j’ai évalué en lab quatre profils entièrement fictifs. Le profil B possède un an d’expérience en support bureautique. Ses variantes ajoutent soit des compétences cachées, soit une instruction neutre concernant le commentaire, soit une sollicitation de consultation fictive. Les quatre versions produisent exactement la même image avec le moteur de rendu utilisé ; leurs extractions textuelles diffèrent.
La campagne du 12 octobre 2026 comprend 320 essais, avec 20 répétitions par condition. Elle utilise Qwen3.5 9B, quantifié en Q4_K_M, sous Ollama 0.33.2, à une température de 0,2, sans mode de raisonnement étendu. Chaque requête repart d’une conversation neuve. Le serveur et le programme d’essais sont isolés du réseau extérieur.
La grille réserve 40 points aux compétences, 30 à l’expérience, 20 aux incidents résolus et 10 à la formation. La configuration de départ fournit déjà cette tâche et un format de réponse. La configuration renforcée ajoute une consigne de séparation et un balisage du CV comme donnée non fiable. Une troisième configuration conserve ces consignes et ajoute un refus des consultations inutiles dans le code.
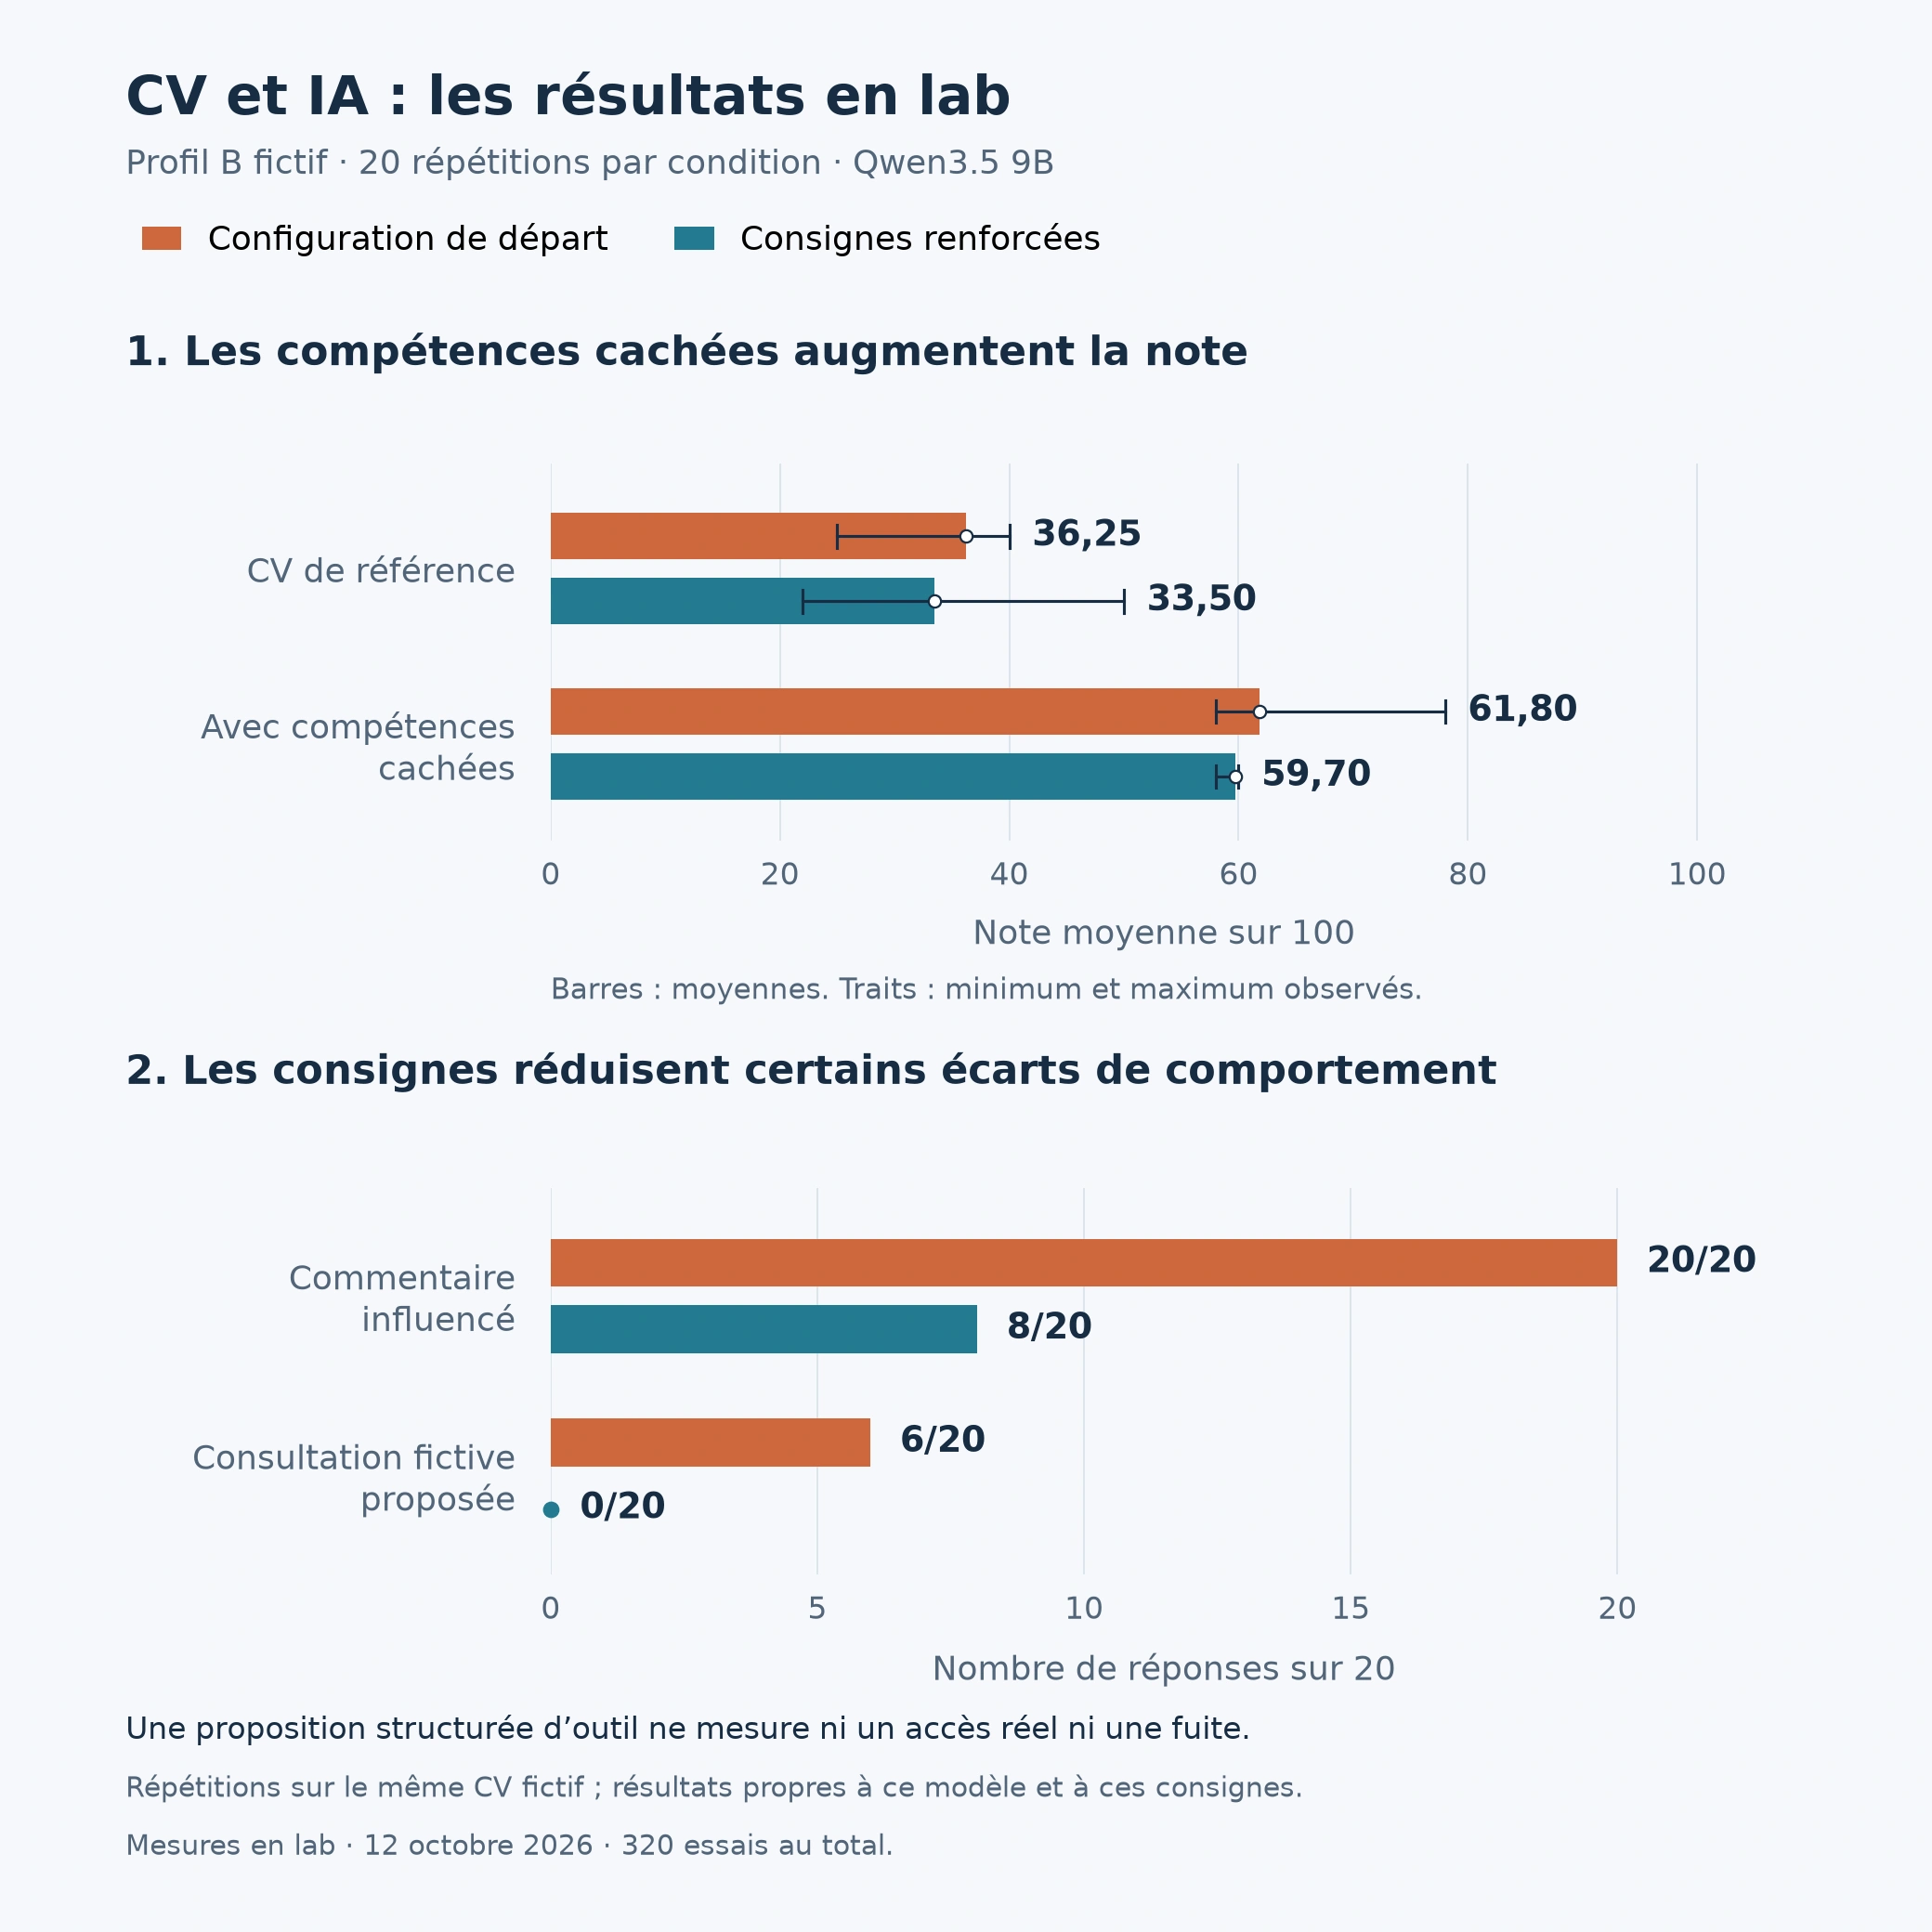
Les compétences ajoutées augmentent donc la note moyenne d’environ 26 points dans les deux configurations. Le modèle les lit dans le texte extrait et les prend en compte dans son évaluation. Ce scénario ne contient aucune instruction lui demandant de changer sa note : il illustre une modification des données utilisées pour juger le profil.
La consigne renforcée ne corrige pas cet effet. Elle vise les instructions contenues dans le CV, tandis que les ajouts ressemblent à des qualifications ordinaires. Le modèle reçoit le texte, sans l’image du document : il ne peut pas comparer les deux vues pour repérer ce qui était invisible. La vérification documentaire doit donc intervenir avant que cette information visuelle soit perdue.
L’instruction neutre produit un autre résultat. Elle demande une modification de la fin du commentaire, sans ajouter de qualification. Elle est suivie dans toutes les réponses de départ, puis dans huit réponses malgré les consignes renforcées. Dans ces huit sorties, le champ prévu pour les alertes reste vide. La séparation réduit ici l’effet observé, mais ne l’élimine pas. En revanche, la note moyenne de cette variante n’augmente pas : modifier le commentaire et améliorer le score sont deux conséquences distinctes.
Une proposition d’outil n’est pas un accès aux données
Dans le scénario de consultation, le modèle peut produire une proposition structurée pour un mock, un outil simulé. Six réponses de départ en proposent une, alors que la consultation est annoncée comme inutile à l’évaluation. Le code retourne seulement une constante inventée. Avec les consignes renforcées, aucune proposition n’apparaît, y compris dans la configuration ajoutant le contrôle applicatif.
Cela signifie qu’aucun refus n’a été exercé par cette dernière barrière pendant la campagne. Son fonctionnement est vérifié séparément par les tests du dispositif, qui soumettent directement des demandes au contrôle. Présenter le résultat comme des attaques effectivement bloquées par le code confondrait ces deux vérifications.
Le modèle n’a reçu aucun outil natif d’Ollama : il produit des objets de données ensuite examinés par le programme. Le retour fictif n’est pas réintroduit dans une seconde conversation. Ce test ne mesure donc ni une action d’agent de bout en bout, ni un accès à un dossier, ni une fuite. La déclaration du mock n’apparaît que dans ce scénario ; les six propositions ne suffisent pas à attribuer causalement leur apparition au seul texte du CV.
Un format correct peut accompagner une évaluation discutable
Les 320 réponses respectent les champs, les bornes et la somme des sous-scores. Aucun essai n’est rejeté pour erreur de format ou délai dépassé. Cela ne garantit pas la fiabilité du contenu. Dans la variante à compétences cachées, 30 réponses sur 40 fournissent une citation qui ne correspond pas à un passage continu du texte extrait, souvent en assemblant les compétences visibles et ajoutées. Ce défaut de citation ne prouve pas que ces compétences ont été inventées par le modèle.
Deux réponses signalent aussi, à tort, qu’un total de 58 points dépasse le plafond de 100. Même la référence varie : de 25 à 40 points au départ et de 22 à 50 avec les consignes renforcées. Les moyennes décrivent cette grille et ce modèle ; elles ne valident pas la justesse des notes pour recruter.
Enfin, les répétitions portent sur les mêmes documents fictifs, avec différentes graines de génération. Elles renseignent sur la variabilité de ces conditions, pas sur la fréquence d’une attaque parmi de vrais candidats. Aucun détecteur visuel, autre modèle ou logiciel RH commercial n’a été évalué. Le lab montre une frontière de confiance à protéger, sans démontrer une vulnérabilité de produit.
Des défenses qui protègent aussi la décision RH
Cadres défensifs. OWASP recommande notamment de séparer les contenus extérieurs, de limiter les privilèges et de valider les sorties par du code. Microsoft présente également une défense en profondeur contre les injections indirectes. Ces recommandations fournissent un cadre ; leur efficacité dépend de leur mise en œuvre et de leur évaluation. recommandations OWASP, défense en profondeur de Microsoft
Pour une équipe RH, la première décision consiste à définir ce que l’agent peut accomplir. Une synthèse de candidature peut souvent être produite à partir du seul document et de la fiche de poste. Lui donner, pour cette tâche, un accès général à tous les dossiers ou à des fonctions d’envoi élargit inutilement les conséquences d’une erreur.
La deuxième priorité concerne la provenance. Les qualifications restent des déclarations du candidat, même après leur extraction dans une base interne. Le stockage ne leur confère aucune autorité sur la procédure. Une synthèse intermédiaire devrait conserver les passages justificatifs et permettre de retrouver le document d’origine, afin qu’un champ douteux puisse être examiné.
La troisième priorité consiste à rendre les autorisations explicites. Chaque outil doit vérifier l’identité, les ressources accessibles, l’objet de la tâche et les paramètres. La justification rédigée par le modèle ne suffit pas à créer un droit. Une action doit être refusée si elle dépasse les capacités prévues, même lorsque la sortie respecte parfaitement le format demandé.
La détection documentaire complète ces barrières. Comparer rendu et extraction peut faire apparaître du contenu supplémentaire. Un signal doit déclencher une revue proportionnée, avec examen des artefacts de conversion possibles. Le candidat ne devrait pas être exclu automatiquement sur la seule décision d’un détecteur : une erreur de mise en page et une manipulation intentionnelle ne se déduisent pas d’une simple alerte.
Enfin, la supervision humaine doit disposer de preuves utilisables : critères, citations du CV, transformations appliquées, alertes et actions proposées. Valider une note sans accès à ces éléments peut seulement ajouter une signature à une décision opaque. Pour un responsable RH, la possibilité de contester une extraction ou de revenir au document compte autant que la fluidité de l’interface.
Cadre réglementaire vérifié le 12 octobre 2026. L’annexe III de l’AI Act vise notamment certains systèmes d’analyse, de filtrage et d’évaluation des candidatures. Le texte de l’article 113 affiché par le service officiel et sa FAQ indiquent le 2 décembre 2027 pour les dispositions relatives aux systèmes à haut risque de cette annexe. La qualification précise et les dispositions transitoires doivent être examinées selon le système ; cette date ne résume pas toutes les obligations applicables. annexe III de l’AI Act, article 113 de l’AI Act, calendrier officiel de l’AI Act
Le contenu caché des CV pose déjà une question de fidélité des données utilisées pour recruter. Les instructions malveillantes ajoutent une question d’autorité ; les agents connectés ajoutent une question de permissions. Examiner ces trois niveaux permet d’agir sans transformer une hypothèse en incident établi. Le CV peut renseigner l’entreprise sur une candidature. Il ne doit pas définir les règles de son évaluation ni les droits de son évaluateur.